
目錄(8 節)

买完服务器 48 分钟,Claude 把 defi.io 搬上了新机器
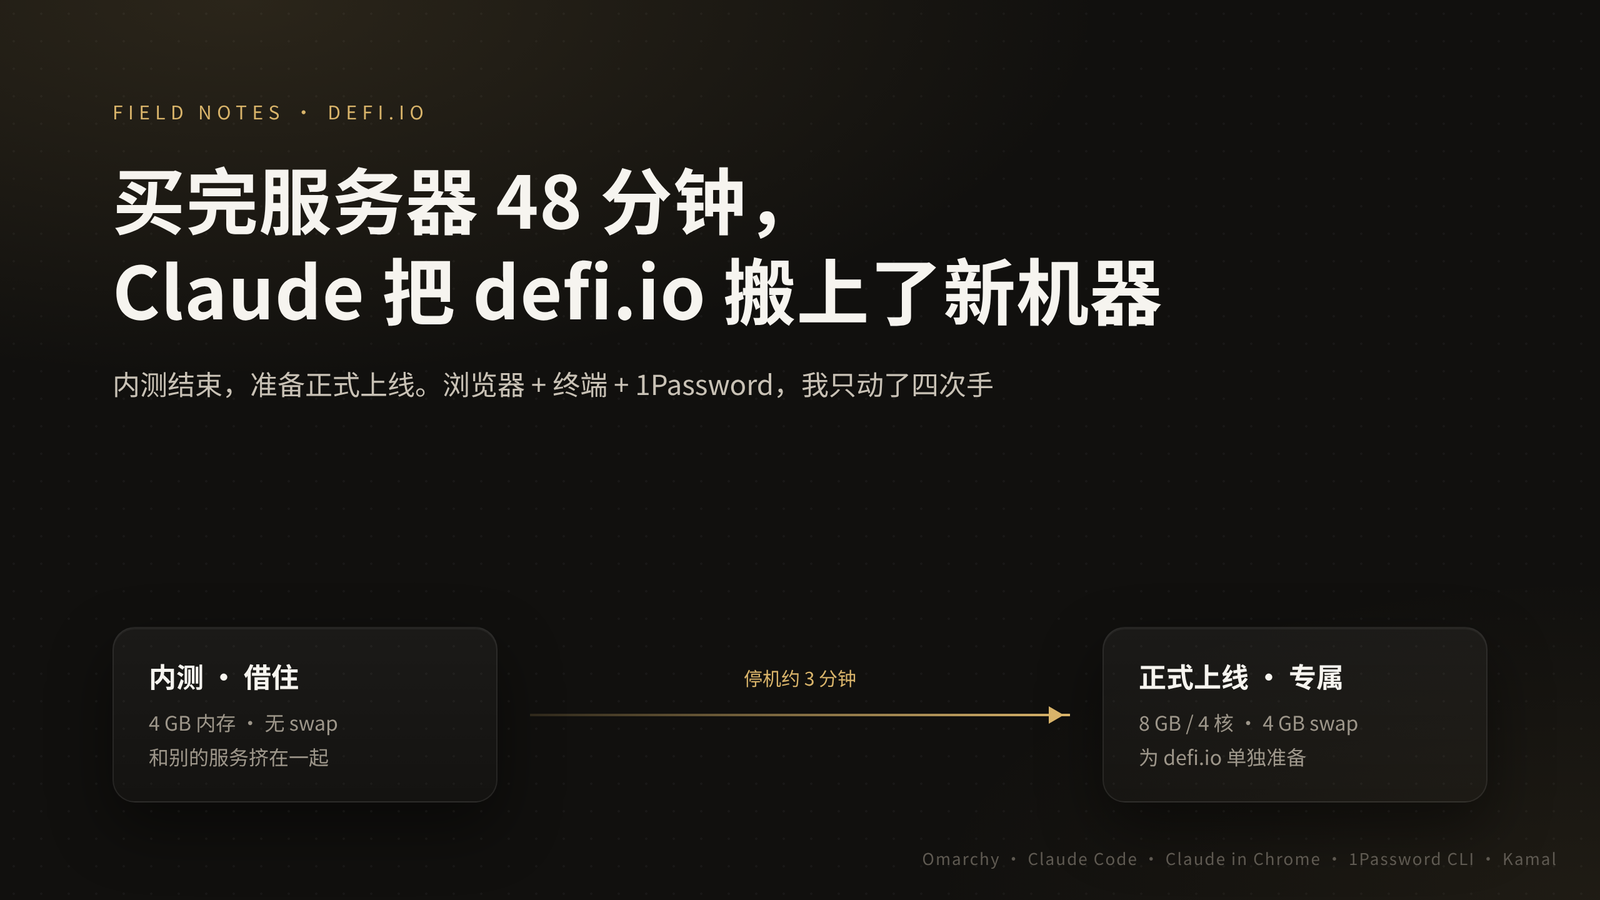
项目内测结束准备正式上线,我单独买了台新服务器。从下单到新机器返回 200 一共 48 分钟,我只动手四次:Claude Code 管终端,Claude in Chrome 管服务商面板,Cloudflare 走 MCP,数据库密码改成从 1Password 现读,停机约 3 分钟。
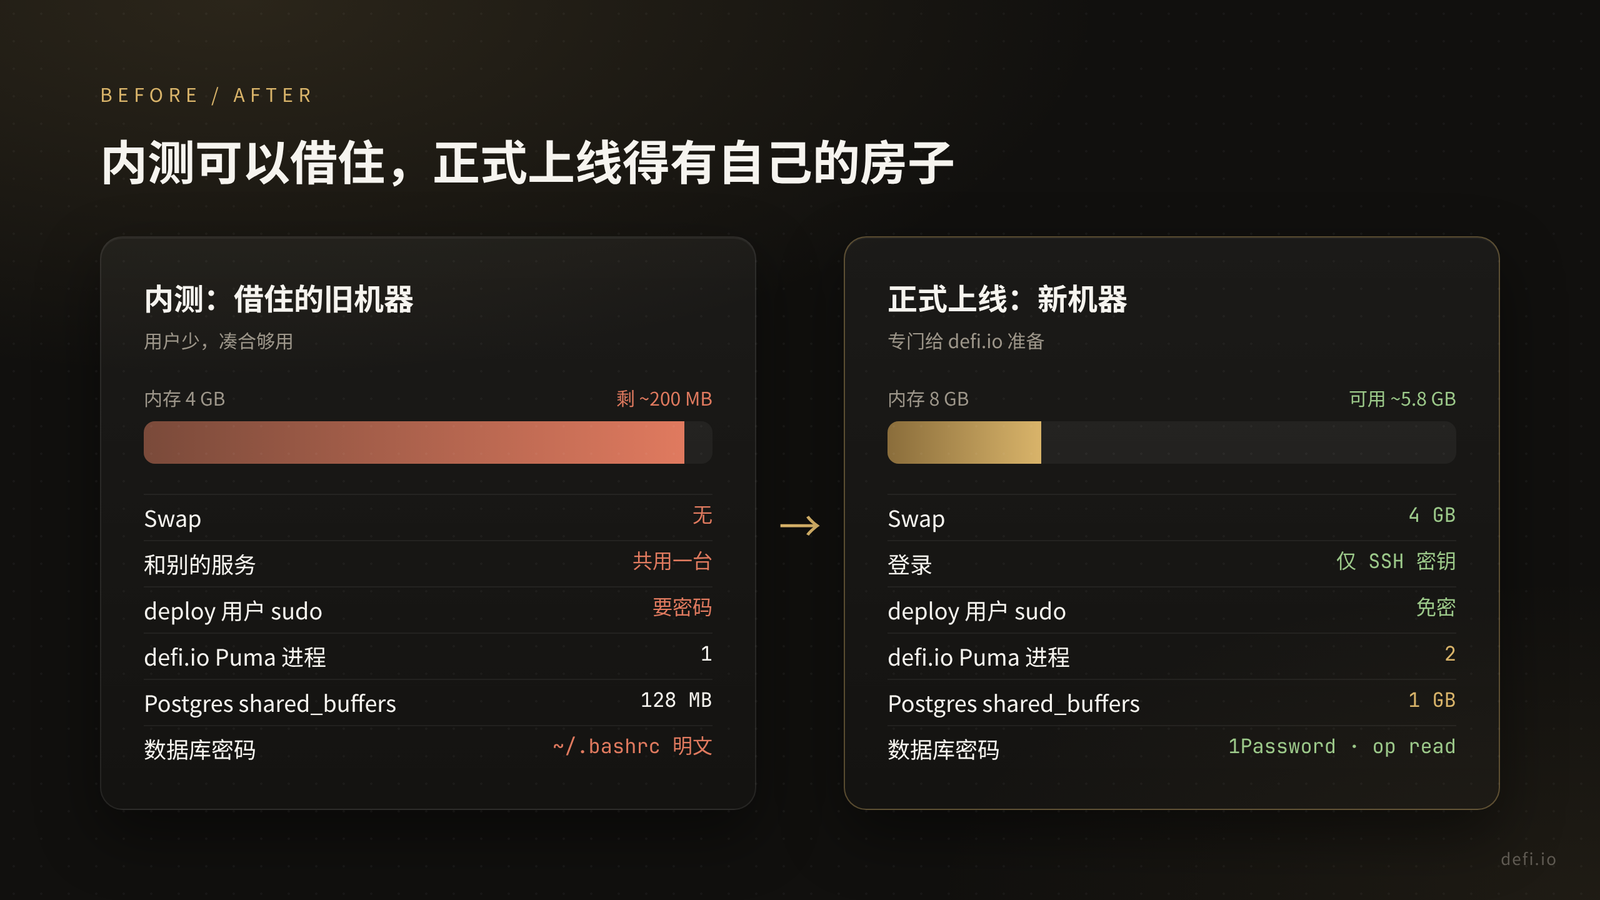
defi.io 内测这段时间,一直借住在我手上一台现成的服务器上。机器不大,4 GB 内存,没有 swap,上面还跑着别的东西。内测用户少,凑合着够用。
现在准备正式上线了,我不想让它继续跟别的服务挤在一起,就单独买了一台 8 GB、4 核的新机器,专门给 defi.io 用。买完之后,我打开终端,跟 Claude Code 说了一句:
我买了新服务器,想把现在的部署迁过去,你给我个方案。
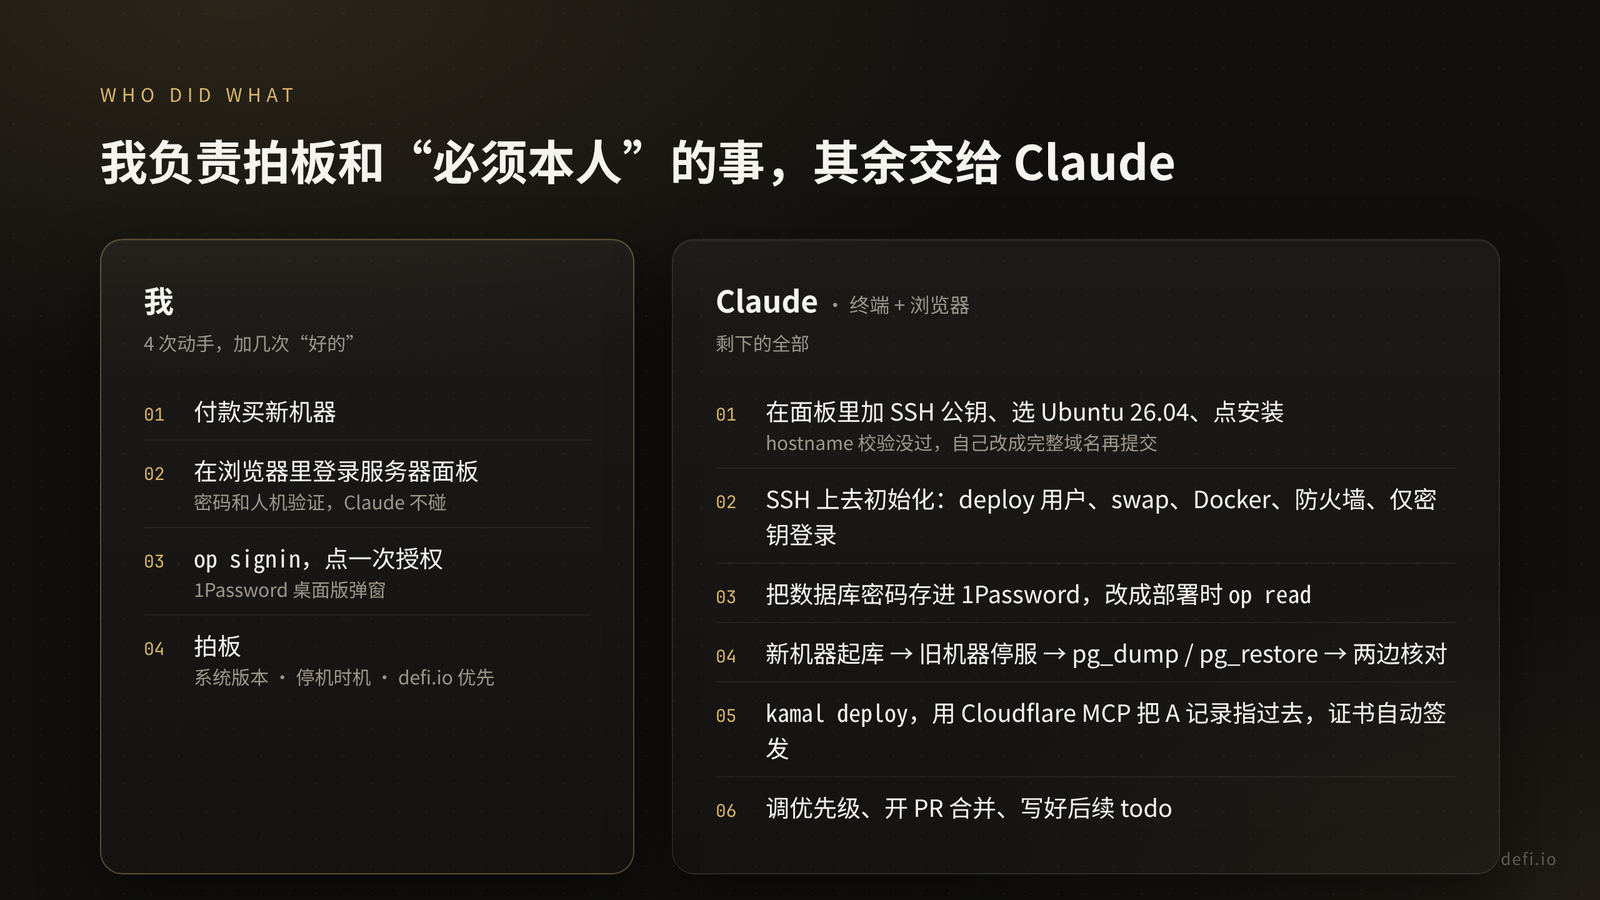
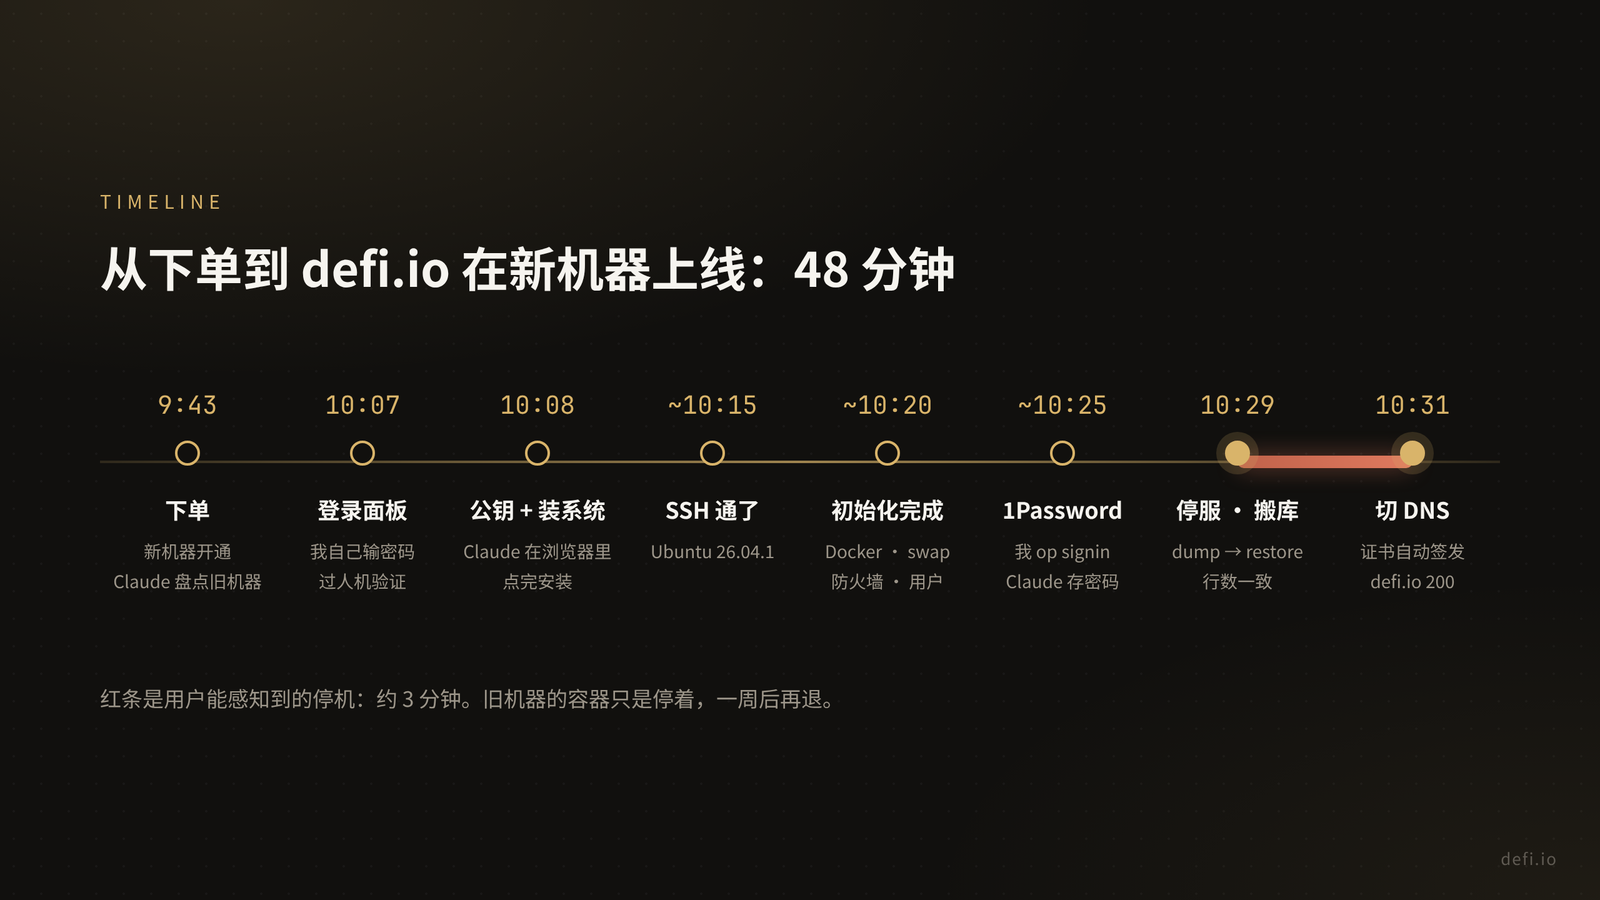
从下单到 defi.io 在新机器上返回 200,一共 48 分钟。这中间我实际动手的次数是四次。
它先去旧机器上看了一圈
我本以为它会直接甩给我一份通用的迁移清单。它没有,而是先 SSH 上旧机器,只读地看了一遍:磁盘用了多少,数据库目录多大,有哪些 Docker volume,内存被谁吃掉了,Cloudflare 上的 DNS 记录是走代理的橙云还是直连的灰云。
方案是基于这些现状写的,所以很具体:用 pg_dump / pg_restore 而不是直接拷数据目录(两边系统的 collation 版本可能不同),旧机器保留一周当后路,新机器的 deploy 用户直接配免密 sudo,省得以后加个 swap 都要先找 root 密码。
看完方案我问了一句:
这些是不是你就直接帮我都能做了?
浏览器那一段
新机器买来是空的,要先在服务商的控制面板里装系统。这一步没有 API,以前我会自己点。这次我用的是 Claude in Chrome,它可以在我已经登录的浏览器里操作。
但登录这件事它不做。面板的登录页有密码和 Cloudflare 的人机验证,它直接跟我说这两样得我来。我在它打开的标签页里登录好,回了一句“已经登录了,你继续”。说实话,这个边界让我更放心,而不是更麻烦。
之后的事它自己做完了:在面板里加上我本机的 SSH 公钥,选系统,填主机名,点安装。
选系统的时候我犹豫了一下,问它 Ubuntu 26.04 是不是比 24.04 好。它没有凭印象回答,而是先去 Docker 官方软件源里查了一下有没有 26.04 的包,确认有,才建议我选 26.04。理由也很实在:标准支持多两年,第一个修复版已经出了,而且我们所有东西都跑在容器里,宿主系统只要能跑 Docker 就行。
点安装的时候还有个小插曲:主机名只填了一个短名字,面板提示 “Hostname invalid”。它看到报错,自己改成了完整域名再提交,没有回来问我。
初始化:它连等待都自己处理
系统装好后它就开始轮询 SSH,大概几分钟就连上了。初始化脚本是它提前写好的:deploy 用户、4 GB swap、Docker 官方源、防火墙只开 22/80/443、SSH 只许密钥登录、自动安全更新。
第一次跑,直接撞上 apt 锁:新机器首次开机时 cloud-init 还在后台跑 apt。它没有硬杀进程,等 cloud-init 结束再跑了一遍。
1Password:顺手把一个老坑填了
这次搬家我还想顺便解决一件事。
以前数据库密码是 export 在 ~/.bashrc 里的。问题在于 .bashrc 第一行是“非交互 shell 直接 return”,所以一旦部署命令不是在交互终端里跑,Kamal 读到的就是空字符串,然后悄悄把空密码推上服务器。我前几天就被它坑过一次:数据库容器起不来,web 容器报找不到数据库主机,查了半天。
所以我说:数据库密码从现在开始,从 1Password 里读。
这里我要做的只有一件事:打开 1Password 桌面版,在“开发者”设置里勾上“与 CLI 集成”,然后在终端里跑一次 op signin,桌面版弹窗,点允许。
剩下的是它做的:把现有密码存成 1Password 条目,存完再读回来,跟原值比对一致(全程不把密码打印出来),然后把 .kamal/secrets 改成部署时用 op read 现读,最后删掉 .bashrc 里那行 export。
现在部署时如果 1Password 没解锁,op read 会直接报错,部署停下来,而不是带着空密码继续往下跑。我觉得这才是对的:失败就该大声失败。
搬家本身,停机大概 3 分钟
真正的迁移步骤其实很朴素:
- 在新机器上先把数据库容器起好;
- 旧机器停掉 web,从这一刻开始算停机;
- 旧库
pg_dump,新库pg_restore; - 两边各查一遍用户数、项目数、迁移版本号,对上了才往下走;
-
kamal deploy到新机器; - 通过 Cloudflare MCP 把 A 记录改到新 IP。
切 DNS 这一步不用开浏览器。我的 Cloudflare 账号早就通过 MCP 接进了 Claude Code,它先查出 defi.io 这条 A 记录的 ID,再调一次接口把内容改成新 IP。走代理的橙云记录,改完立刻生效。
DNS 一切过去,新机器上的 kamal-proxy 自动去 Let’s Encrypt 签证书。它翻了一下 proxy 日志,确认验证请求已经进来,然后用 curl 测了几次首页,全是 200。
从停掉旧 web 到新站返回 200,大约 3 分钟。旧机器上的容器只是停着,数据都在。万一有问题,DNS 改回去,容器起起来就行。我打算观察一周再退掉它。
给 defi.io 开小灶
搬完之后我跟它说了一句:defi.io 是这台机器上最重要的应用,这台机器就是为它准备的。
它据此给了三条调整,都是我能听懂的:
- 加并发:Puma 从 1 个进程改成 2 个。之前压到 1 个,是为了挤进旧机器那点内存。
-
数据库调参:
shared_buffers从默认的 128 MB 调到 1 GB,effective_cache_size设成 3 GB。 -
内存吃紧时先保 defi.io:以后这台机器上再放别的东西,一律设内存上限,并且加一个
oom-score-adj: 500。
调数据库参数之前我追问了一句:设成 1 GB,没用到的话它不会真占那么多吧?
它的回答我记住了。effective_cache_size 只是告诉查询规划器“系统大概有这么多缓存”,一个字节都不占。shared_buffers 是上限,Linux 按需分配,数据读进来才占用,所以现在库只有几十 MB 的时候,实际也就多占几十 MB。但它只涨不降,填满之后就一直占着,直到重启。这不是泄漏,数据库缓存本来就是这样设计的。
oom-score-adj 我也是这次才搞明白:这是 Linux 内核自带的机制。整台机器内存和 swap 都耗尽时,内核的 OOM Killer 会挑一个进程杀掉,分数最高的先死。+500 的意思就是“先杀我”。defi.io 保持默认的 0,排在最后。
为什么 Omarchy 让这件事特别顺
最后说一下我用的系统。我的日常电脑跑的是 Omarchy,一个基于 Arch Linux 和 Hyprland 的开源桌面系统。
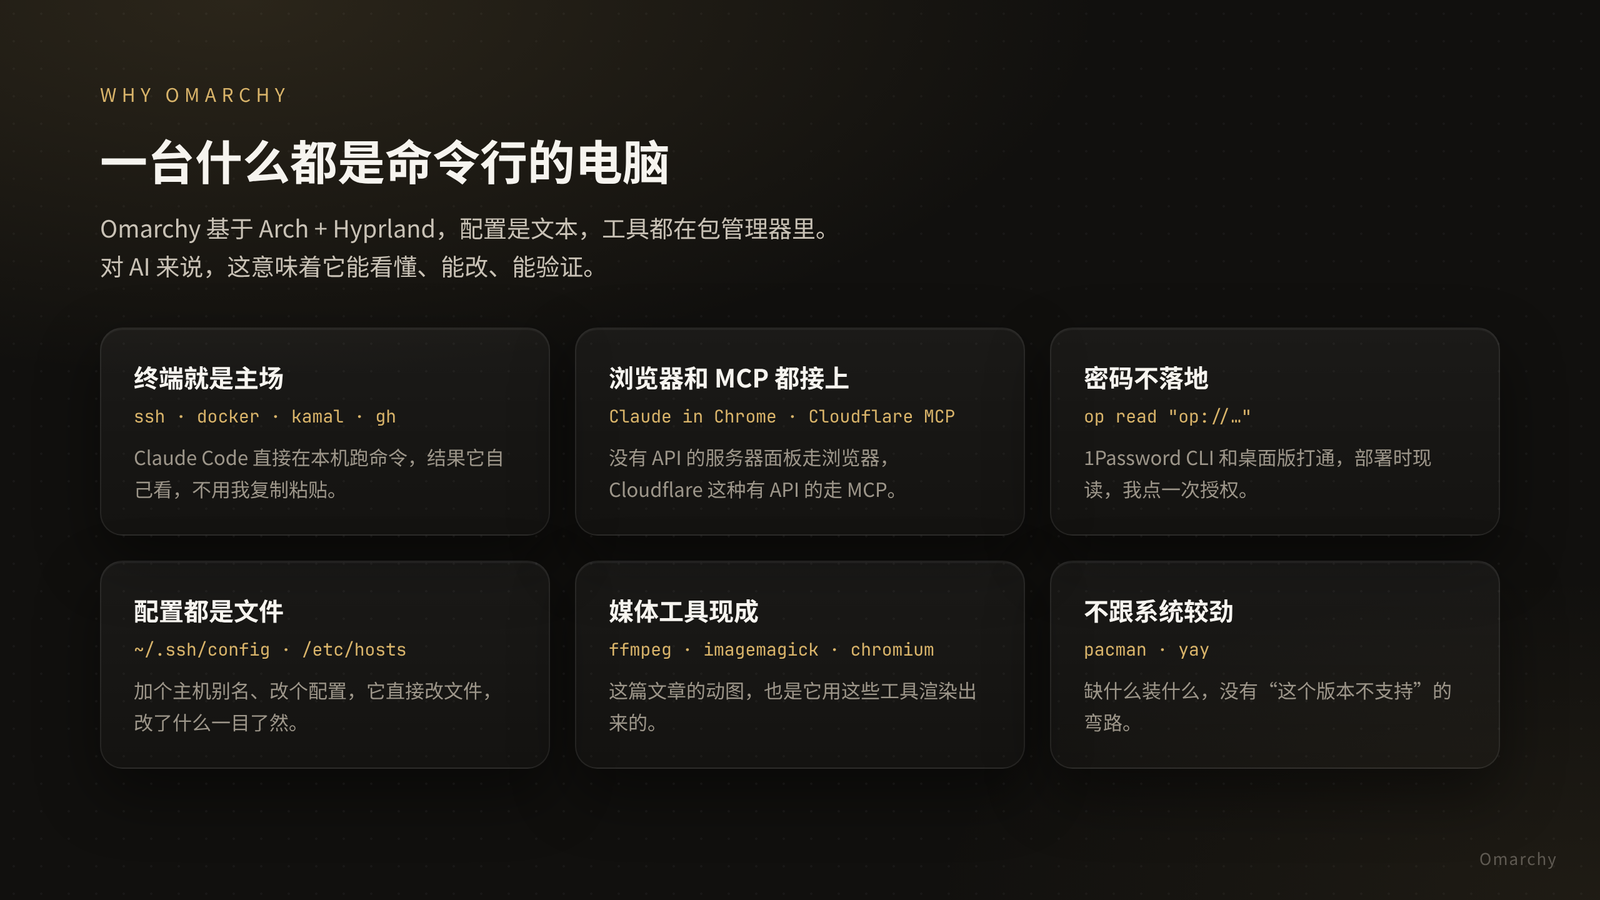
这件事能这么顺,跟系统关系很大。在 Omarchy 上几乎一切都是命令行和文本配置:SSH 别名是 ~/.ssh/config 里的几行,hosts 是一个文件,1Password CLI、Docker、Kamal、gh、ffmpeg 都是包管理器里装好的。对 Claude 来说,这意味着它能看懂我的环境,能直接改,改完还能自己验证,不需要我当中间人去复制粘贴。
浏览器也一样。服务器面板这种没有 API 的地方,Claude in Chrome 在我已经登录的浏览器里操作;有 API 的,比如 Cloudflare,就走 MCP。终端、浏览器、MCP 三条路都通了,一个人能做的事就几乎都能交给它。
这篇文章里的动图和配图,也是它在这台电脑上用 Chromium 和 ffmpeg 渲染出来的。
几点体会
边界清楚,反而敢放手。 密码和人机验证,它一概不碰,到了这一步就直接让我来。数据库密码进 1Password 的时候,它也是存完读回来比对,全程不把明文打印出来。有这条线在,我才敢把“初始化服务器”这种事整个交给它。
每一步都有验证。 恢复完数据库,两边对行数;部署完,看健康检查;切完 DNS,看证书日志,再用 curl 测。它不会说“应该好了”,它会给我看结果。
留后路比快更重要。 旧机器留一周,数据不动;密码先存进 1Password、读回来比对一致,才去删 .bashrc 里那一行。每个不可逆的动作前面,都有一个能回头的版本。
我真正做的,是决定。 选哪个系统,什么时候停机,谁优先。其余的,交给一个会自己查资料、自己验证、知道什么不该碰的搭档就好。
搬完之后,它留给我的唯一一项作业,是一周后记得叫它去把旧机器退掉。
它怕我忘,已经把这件事写进 todo 了。
注:搬家当天没有录屏。文中的终端动图是事后用当天的真实输出重放渲染的。IP、账号这些都已打码,主机名换成了 old-vps / new-vps。
最后想认真说声谢谢。这件事能做得这么顺,靠的是几个我每天都在用、也真心喜欢的工具:Claude Code 和 Claude in Chrome 把终端和浏览器里的活接了过去;1Password 让我第一次觉得,自动化和密码安全可以不打架;Omarchy 让整台电脑对 AI 敞开,几乎没有它够不着的地方。少了哪一个,这 48 分钟都会变得长很多。
轉發此貼文?
與您的關注者分享。
回覆