
目錄(8 節)

英伟达 DGX Spark 能跑哪些模型,值得买吗?
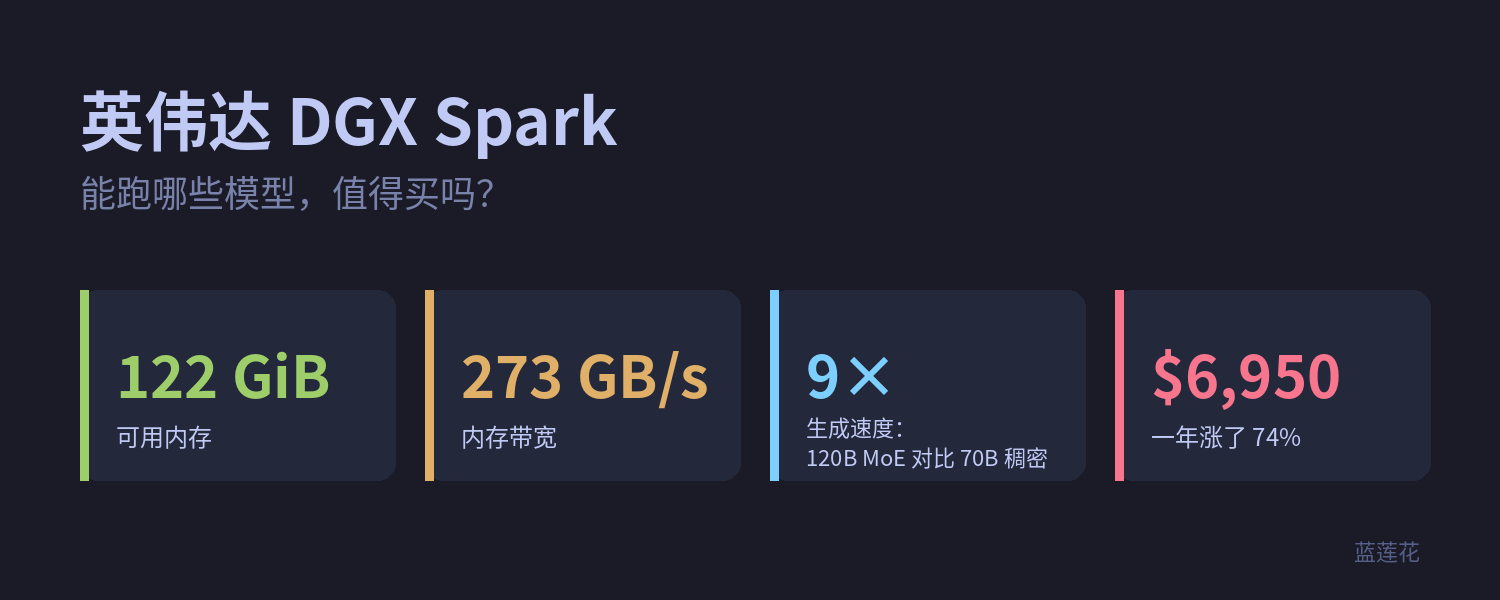
英伟达 DGX Spark 有 122 GiB 可用内存,但带宽只有 273 GB/s:装得下的模型很多,跑得快的只有 MoE。实测 gpt-oss-120b 比稠密 Llama 70B 快 9 倍多。再算一笔账:一年涨价 74% 的 Spark,和订阅相比值不值。
一台巴掌大的 NVIDIA DGX Spark,系统里显示的可用内存是 121.93 GiB。这个数字很容易让人误会:既然 128 GB 都能当显存用,那是不是什么大模型都能跑?
答案是:装得下,不等于跑得快。这台机器能跑什么,取决于两个数字,而它们说的是两件完全不同的事。
两个数字:容量和带宽
DGX Spark 用的是 NVIDIA GB10 芯片,CPU 和 GPU 共用一块 128 GB 的 LPDDR5x 内存,扣掉系统占用,实际可用约 122 GiB。对比一下:一张 RTX 5090 的显存是 32 GB。所以论“装得下”,Spark 一台顶四张高端游戏卡。
但它的内存带宽只有约 273 GB/s,而 RTX 5090 是 1.8 TB/s,差了六倍多。
容量决定能不能装下,带宽决定说话有多快。
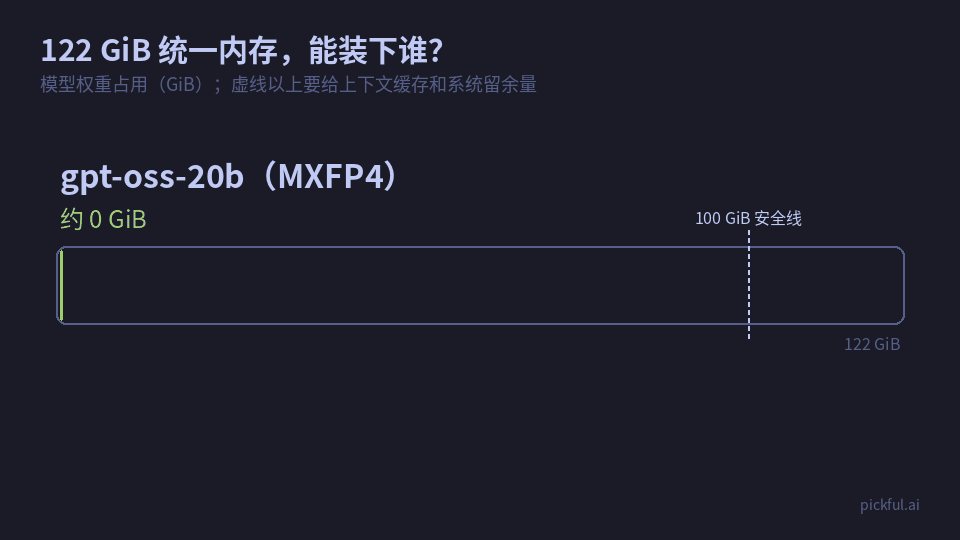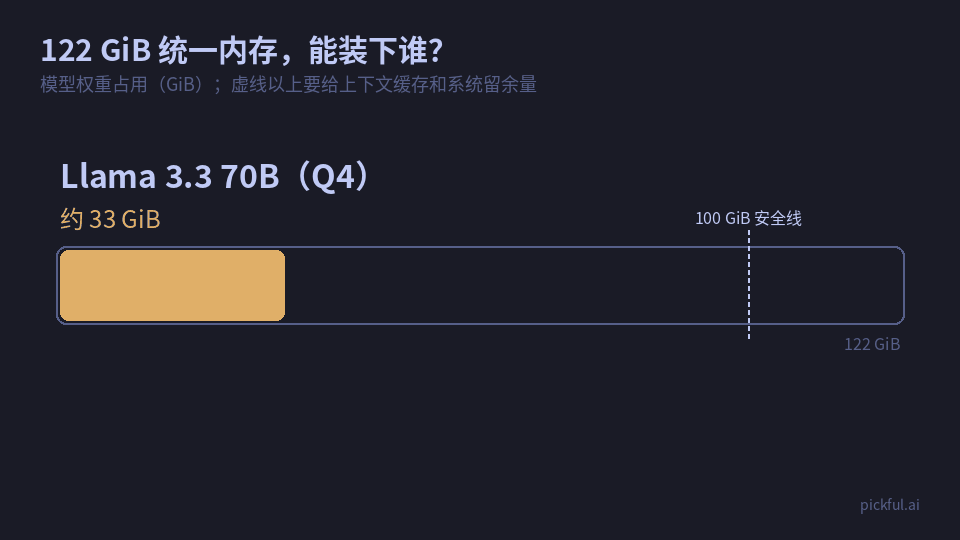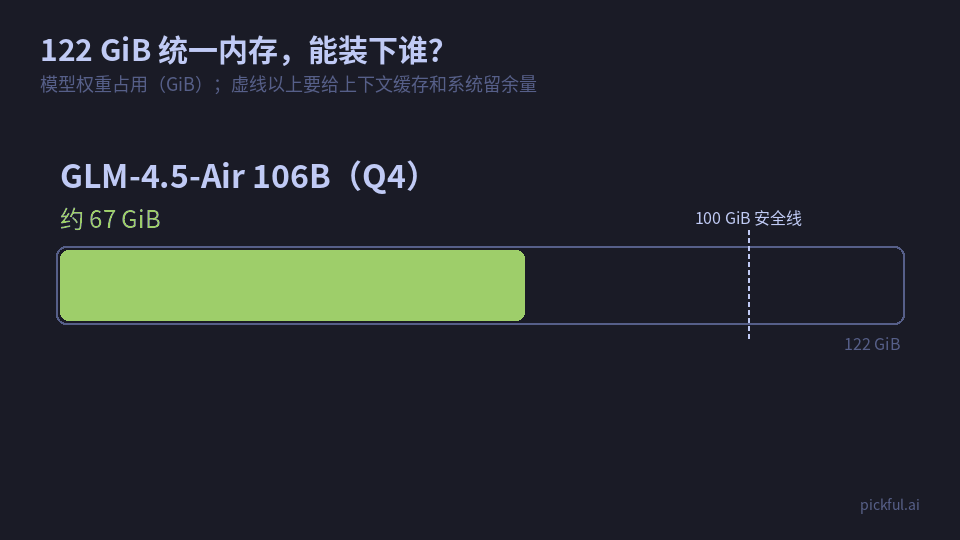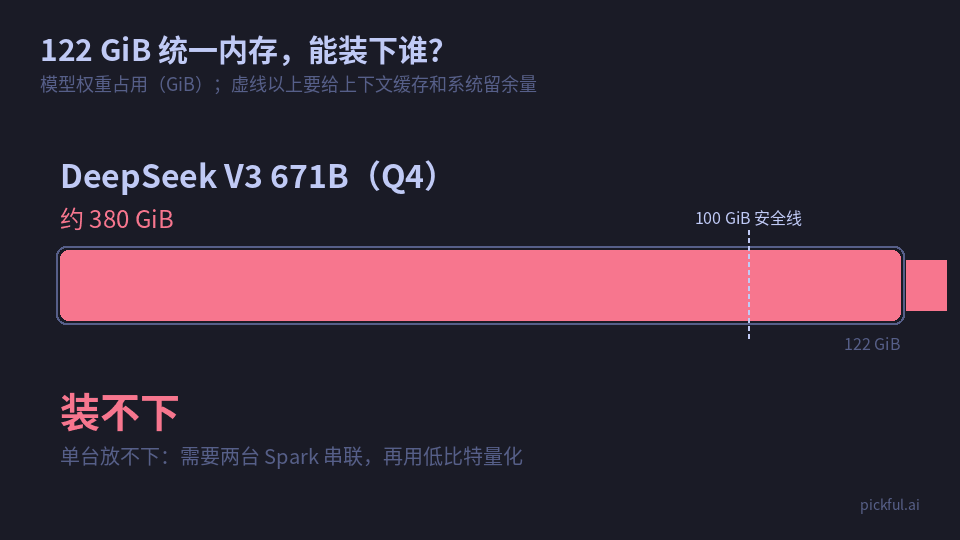
按权重大小排一遍:gpt-oss-120b 约 61 GiB,GLM-4.5-Air 的 4 比特版本约 68 GiB,都能稳稳装下,还能给上下文缓存留出 40 GiB 以上。Qwen3-235B 要压到 3 比特才能塞进去,剩下的空间已经很紧。DeepSeek V3 这种 671B 的模型,4 比特也要 380 GiB 左右,单台无论如何放不下。
一个实用的经验:权重别超过 100 GiB。超过这条线,长上下文的缓存就没地方放了。
速度只看一个公式
模型每生成一个 token,都要把这一步用到的权重从内存里完整读一遍。所以单用户的生成速度有一个硬上限:
生成速度上限 ≈ 内存带宽 ÷ 每个 token 要读的字节数
一个 4 比特(Q4_K_M)的 Llama 70B 约 42.5 GB,273 ÷ 42.5 ≈ 6.4,这就是它的理论天花板。实际跑下来还要打折扣。
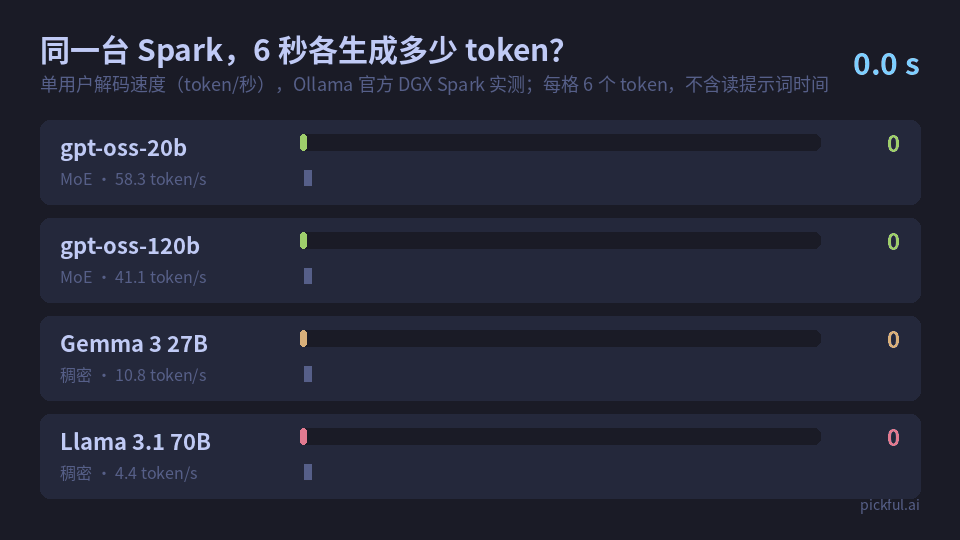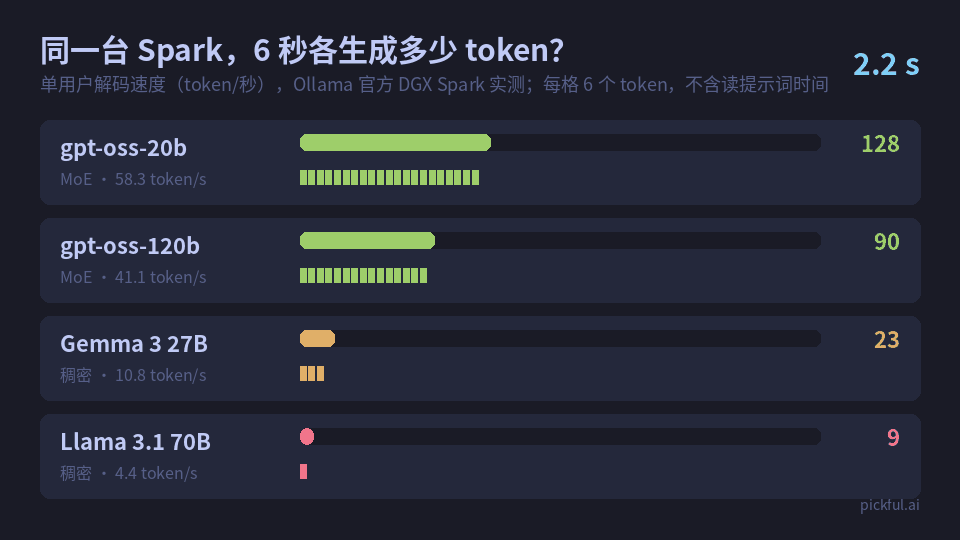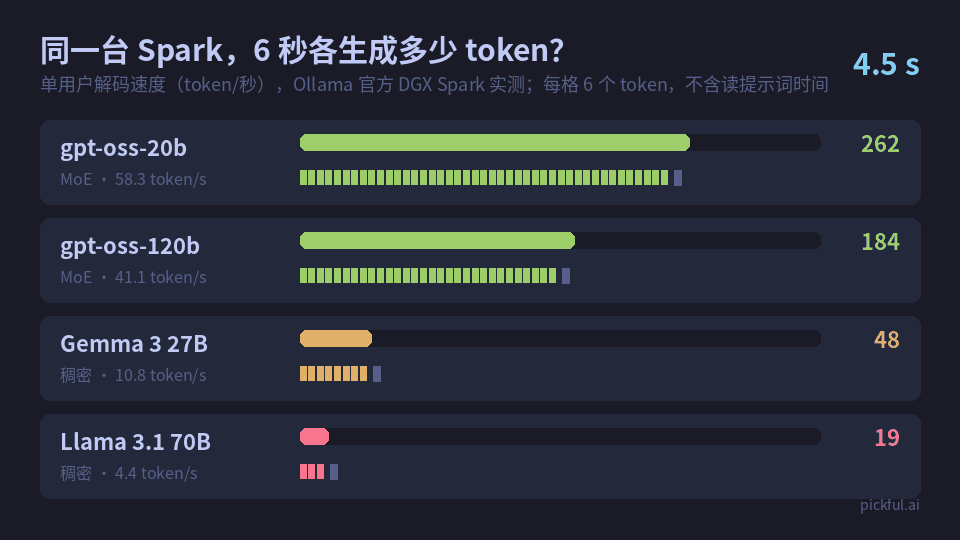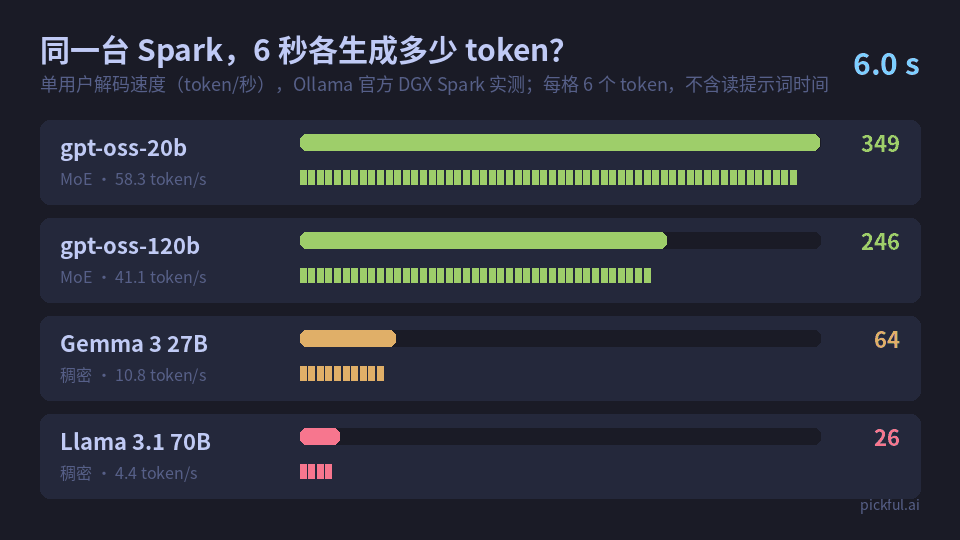
Ollama 官方在 DGX Spark 上的实测数据:
| 模型 | 类型 | 量化 | 生成速度(token/秒) |
|---|---|---|---|
| gpt-oss-20b | MoE | MXFP4 | 58.3 |
| gpt-oss-120b | MoE | MXFP4 | 41.1 |
| Gemma 3 27B | 稠密 | Q4 | 10.8 |
| Llama 3.1 70B | 稠密 | Q4 | 4.4 |
每秒 4 个 token,看着它一点一点往外挤,交互是很难受的。
反直觉的地方:120B 比 70B 快近 10 倍
表里最有意思的一行是 gpt-oss-120b:参数量比 Llama 70B 多七成,速度却是它的 9 倍多。
原因是架构。Llama 70B 是稠密模型,每生成一个 token,700 亿个参数全部参与计算,全部要从内存里读一遍。gpt-oss-120b 是 MoE(混合专家)模型,1170 亿参数分成很多个“专家”,每个 token 只调用其中几个,实际激活的参数只有约 50 亿。
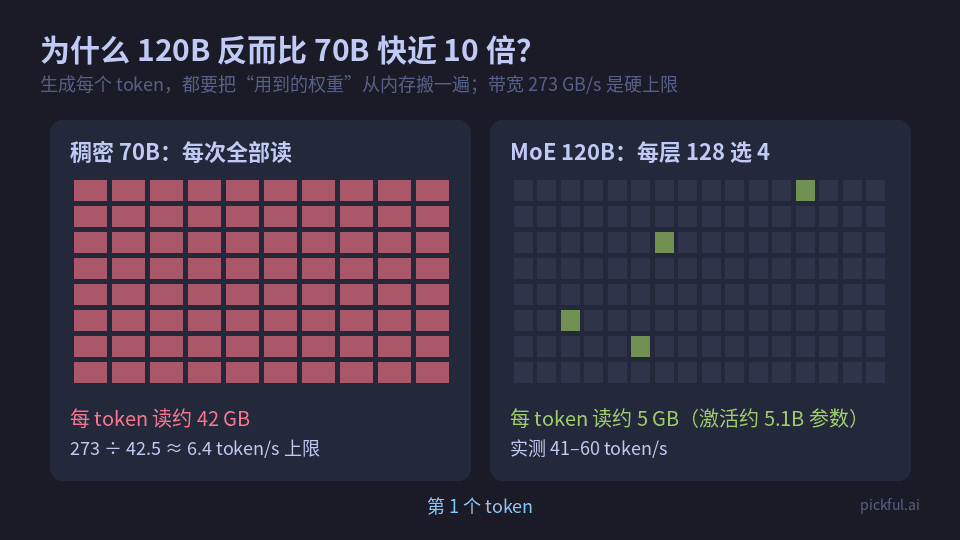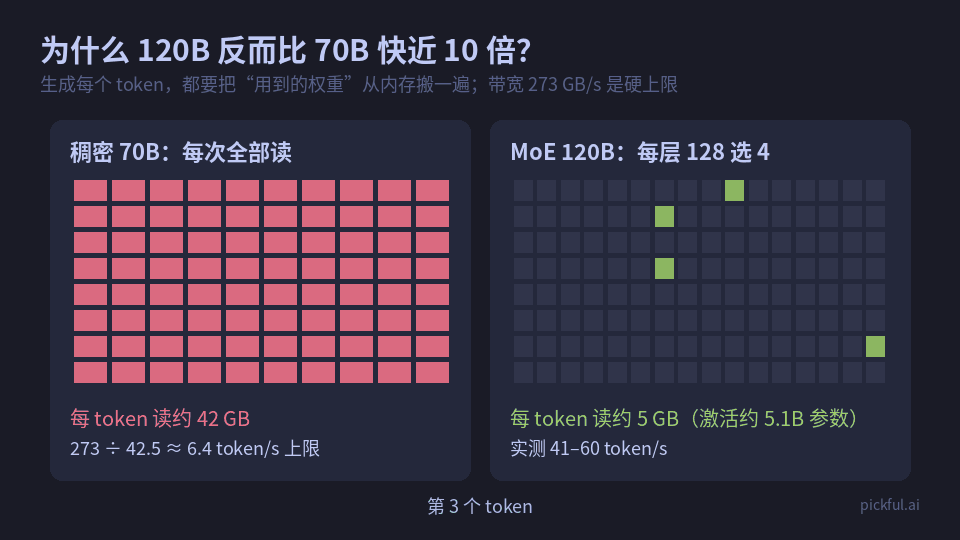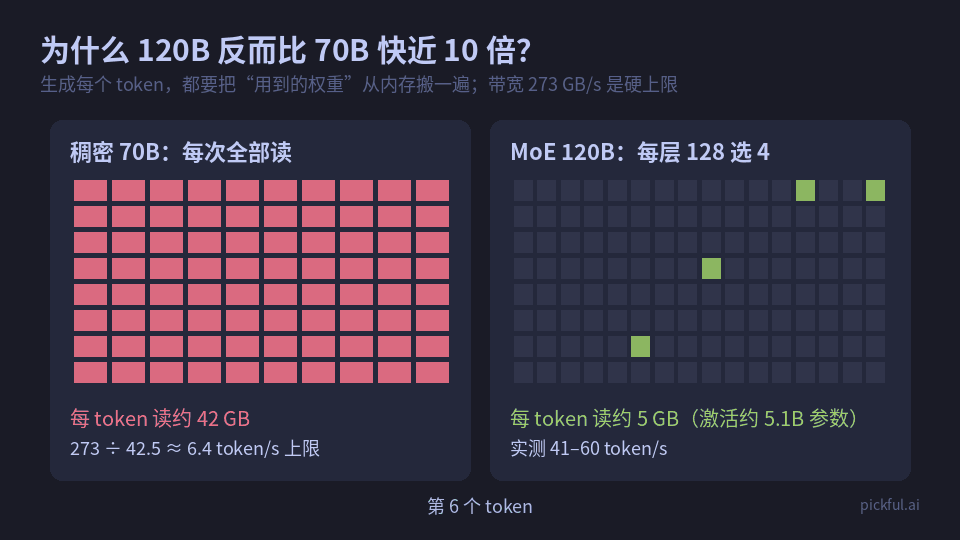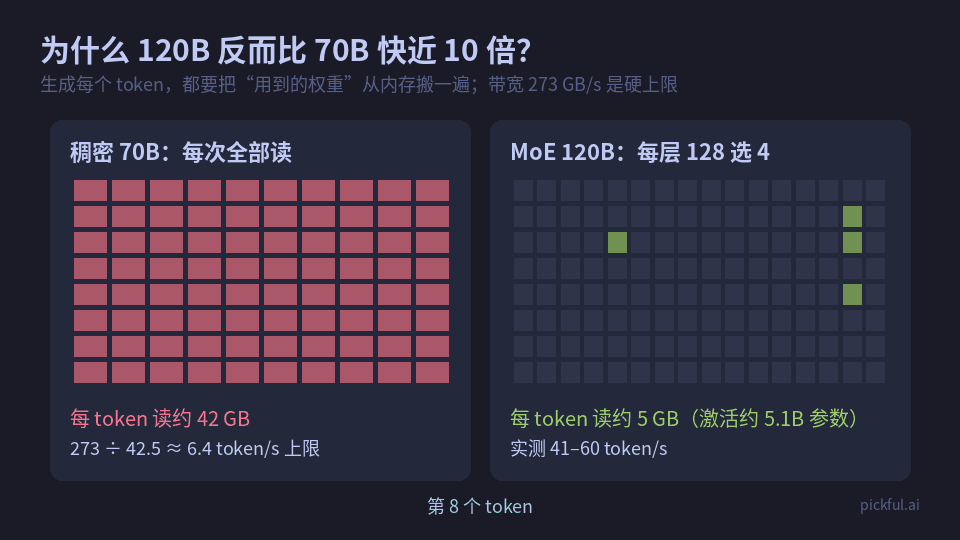
稠密 70B 每个 token 读约 42 GB,MoE 120B 只读约 5 GB:选中的专家约 2 GB,注意力层和输出层精度更高,又占约 3 GB。在带宽受限的机器上,这就是近十倍的差距。
这也决定了 Spark 的选型逻辑:它是为 MoE 模型准备的机器。总参数可以很大,因为内存够;激活参数必须小,因为带宽不够。
实际能跑什么
按这个逻辑,把常见开源模型分成七档:
| 档位 | 模型 | 权重大小 | 体感 |
|---|---|---|---|
| ✅ 主力 | gpt-oss-120b | 约 61 GiB | 每秒 41–60 token,看引擎和调优 |
| ✅ 很快 | gpt-oss-20b、Qwen3-30B-A3B | 13–18 GiB | 每秒 50 token 以上,适合 agent 和批量任务 |
| ✅ 好用 | GLM-4.5-Air(106B,激活约 12B) | 约 68 GiB | 每秒 15–25 token(估算) |
| ⚠️ 能跑但慢 | Llama 70B、Qwen 72B 等稠密模型 | 约 40 GiB | 每秒 3–6 token |
| ⚠️ 勉强 | Qwen3-235B-A22B(3 比特) | 约 104 GiB | 每秒 8–12 token(估算),上下文很紧 |
| ❌ 单台不行 | DeepSeek V3 / R1(671B) | Q4 约 377 GiB | 单台不行,两台只能跑约 2 比特版本 |
| ❌ 两台也不行 | Kimi K2(约 1T) | Q4 约 578 GiB | 两台 Spark 也装不下 |
推理引擎的选择也会影响速度。论坛里的实测是:同样跑 gpt-oss-120b,llama.cpp 约 46 token/s,SGLang 约 52,调优过的 vLLM 能到 60 token/s。单用户场景,llama.cpp 最省心;多人共用、要高并发,再上 vLLM。
两台串起来:256 GB
Spark 自带 ConnectX-7 高速网卡,两台可以直连,用张量并行把一个模型切成两半,各跑一半。
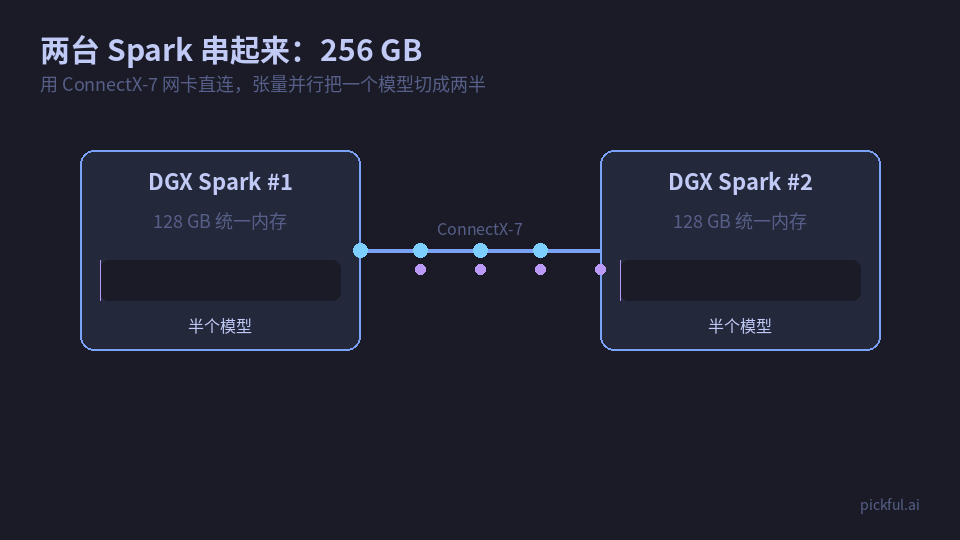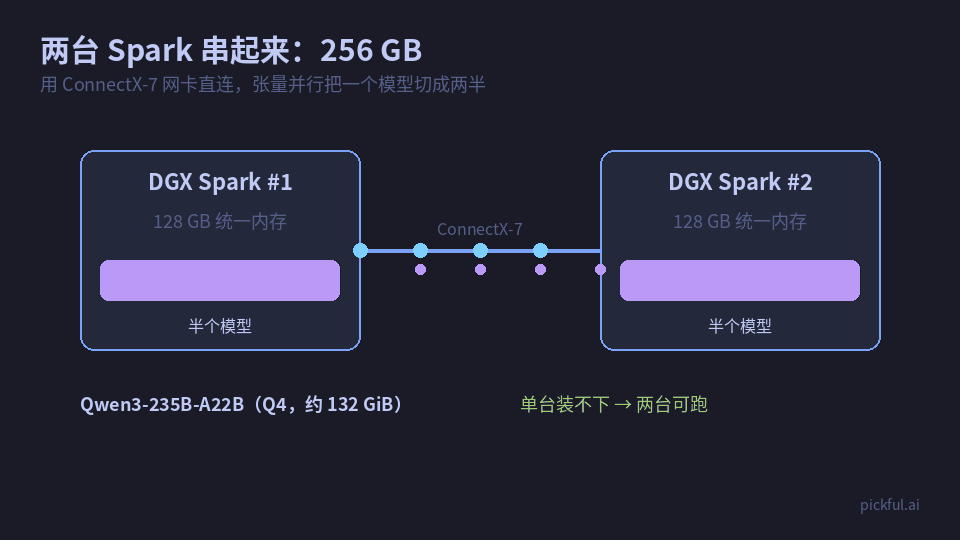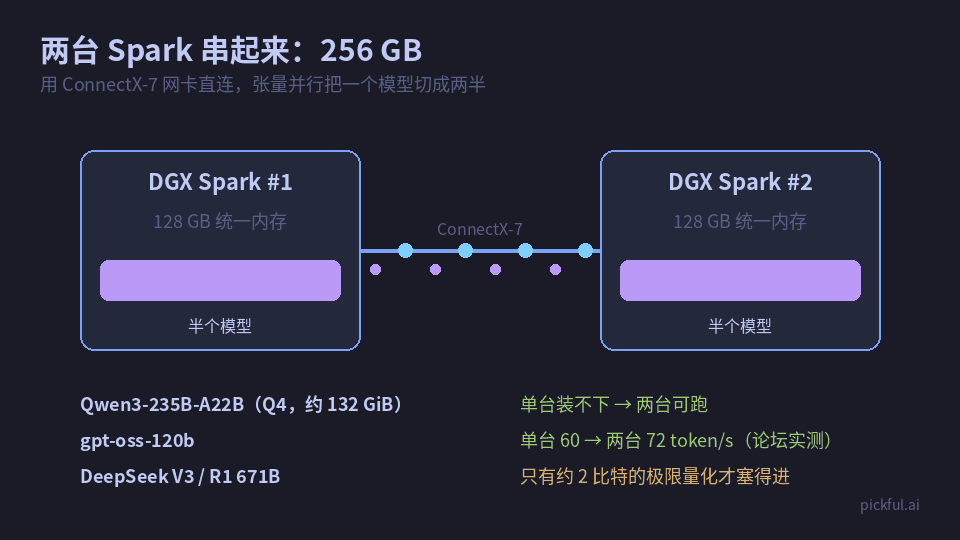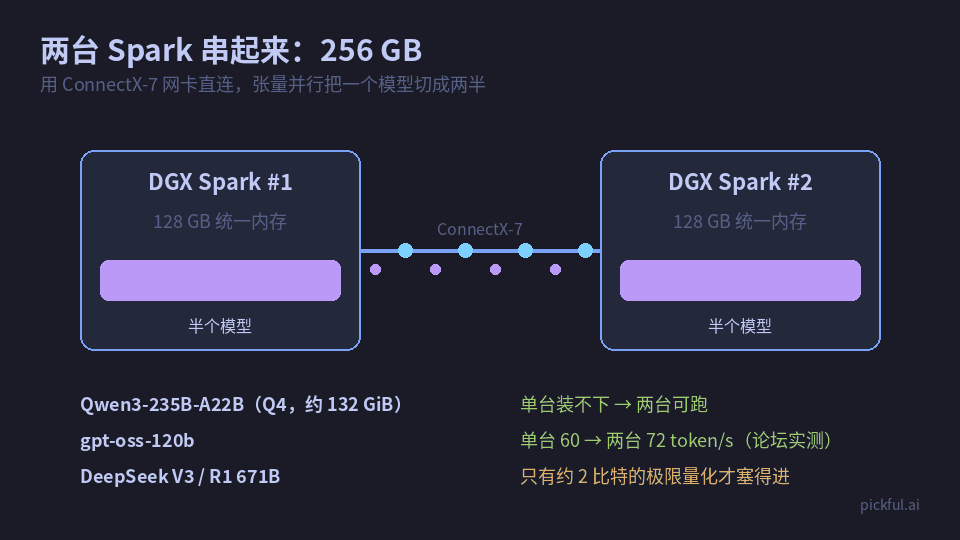
两台的总内存到 256 GB,Qwen3-235B 就能用 4 比特完整跑起来。gpt-oss-120b 在论坛实测中从单台 60 token/s 提到两台 72 token/s,提升不大,因为它本来就不缺内存。至于 DeepSeek 671B,两台也只能塞进约 2 比特的极限量化版本,质量损失明显,不太值得。
值不值这个价
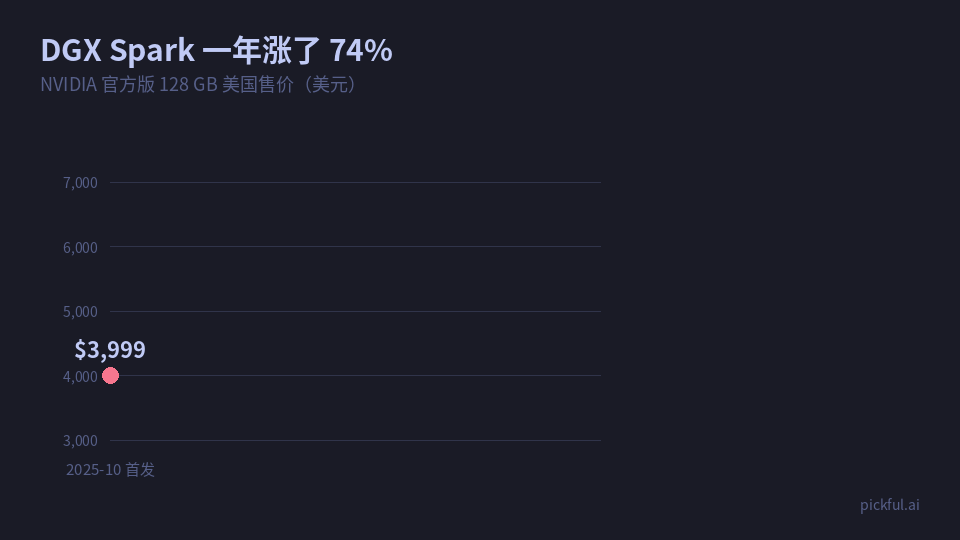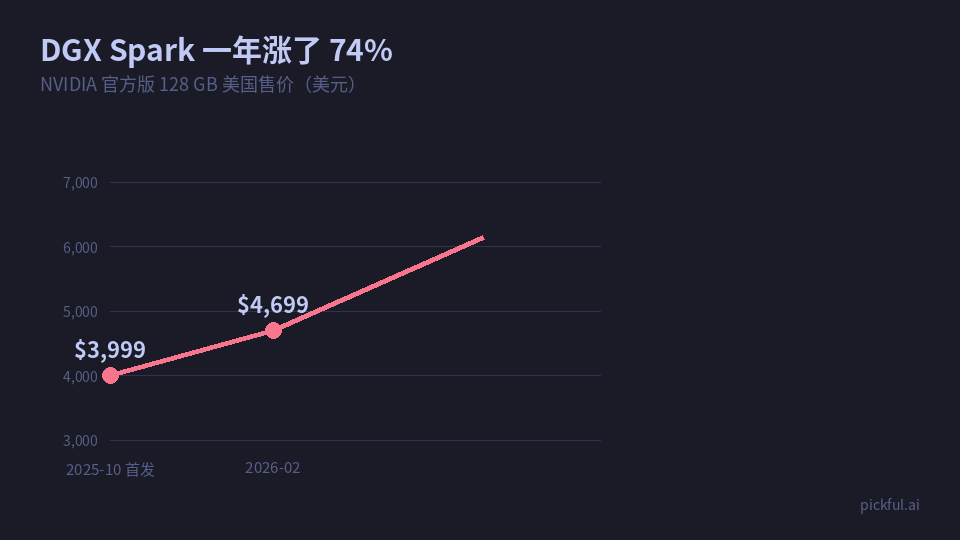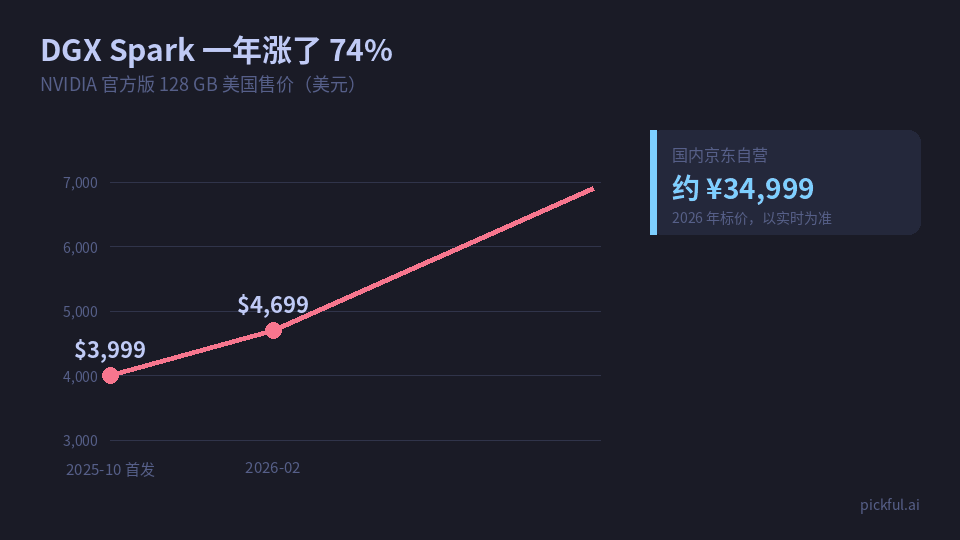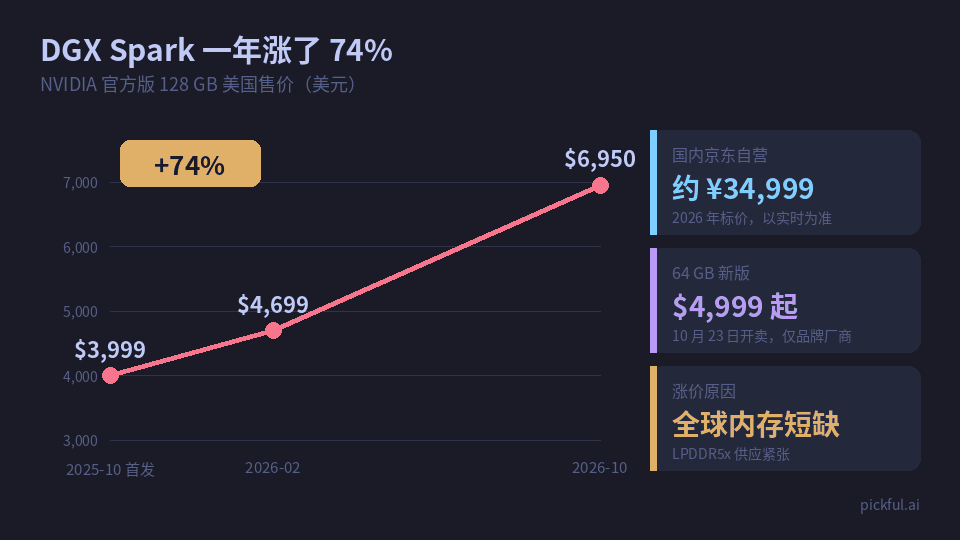
这台机器在过去一年里越卖越贵。NVIDIA 官方版 128 GB 首发价 3,999 美元,2026 年 2 月涨到 4,699 美元,10 月再涨到 6,950 美元,一年涨了 74%。国内京东自营的标价约 34,999 元。2 月涨价时,NVIDIA 官方给出的理由是内存供应紧张;10 月这次,媒体也普遍归因于全球内存短缺。
把价格和前面反复讲的带宽放在一起看:
| 机器 | 国内参考价(2026 年,以实时为准) | 内存 | 带宽 |
|---|---|---|---|
| AMD AI Max+ 395 迷你主机 | 约 ¥14,999 | 128 GB | 256 GB/s |
| DGX Spark | 约 ¥34,999 | 128 GB | 273 GB/s |
| Mac Studio M5 Max | 约 ¥39,499 | 128 GB | 614 GB/s |
| RTX PRO 6000 显卡 | 约 ¥79,000 | 96 GB | 1,792 GB/s |
同样 128 GB,AMD 迷你主机带宽和 Spark 差不多,价格不到一半;Mac Studio M5 Max 只贵约 4,500 元,带宽是 Spark 的 2.2 倍,生成速度明显更快。单论“本地跑大模型”,Spark 并不占便宜。
它多出来的钱,买的是 NVIDIA 的软件栈:CUDA、vLLM、SGLang、TensorRT-LLM 开箱即用,读长提示词快,能做微调,在这里调好的东西可以原样搬到数据中心的 NVIDIA 服务器上。这些用不上,就不值这个价。
它适合谁
把这台机器想成一个能装下大模型、但说话不快的工作站:
- 日常对话和编程辅助,用 gpt-oss-120b,速度和质量都够用;
- 跑 agent、批量处理文档,用较小的 MoE 模型;上述实测中,gpt-oss-20b 的解码速度比 gpt-oss-120b 快约 40%;
- 微调 70B 以内的模型(QLoRA),这是 128 GB 内存真正的优势场景;
- 稠密 70B 只适合不在乎等待的离线任务;如果一定要用,可以加一个小模型做“投机解码”,速度能明显提升。
如果你的主要需求是“一个人和一个大模型飞快地聊天”,Mac Studio 或者大显存显卡更合适;只想低成本装下 100B 级别的模型,AMD 迷你主机更划算。只有工作离不开 CUDA、要做微调、或者要和数据中心用同一套软件时,Spark 才值这个价。
挑模型时只问两个问题:总参数装不装得下 122 GiB?激活参数够不够小?两个都满足,就是这台机器的好搭档。
买机器,还是买订阅
算完硬件账,还有一笔更直接的账。
我自己的选择是订阅:Claude Max 5x 每月 100 美元,加一个 ChatGPT Plus(含 Codex)每月 20 美元,一年合计 1,440 美元。一台 6,950 美元的 Spark,够付这两个订阅将近 5 年;只算 Max 5x,够付将近 6 年。按国内京东价 34,999 元算,也够付三年多。
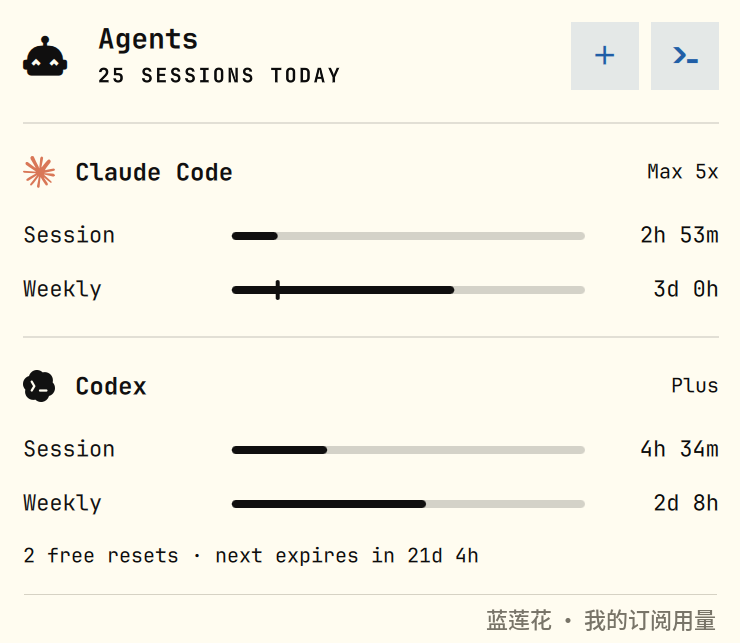
这是我某一天的用量:开了 25 个 agent 会话,Claude Code 的周额度用了六成左右,离重置还有 3 天;Codex 的周额度用了一半多。按这个强度,两个订阅基本够用,而且用的是最前沿的模型。本地最好的 gpt-oss-120b,在写代码和长任务上和它们仍有差距。
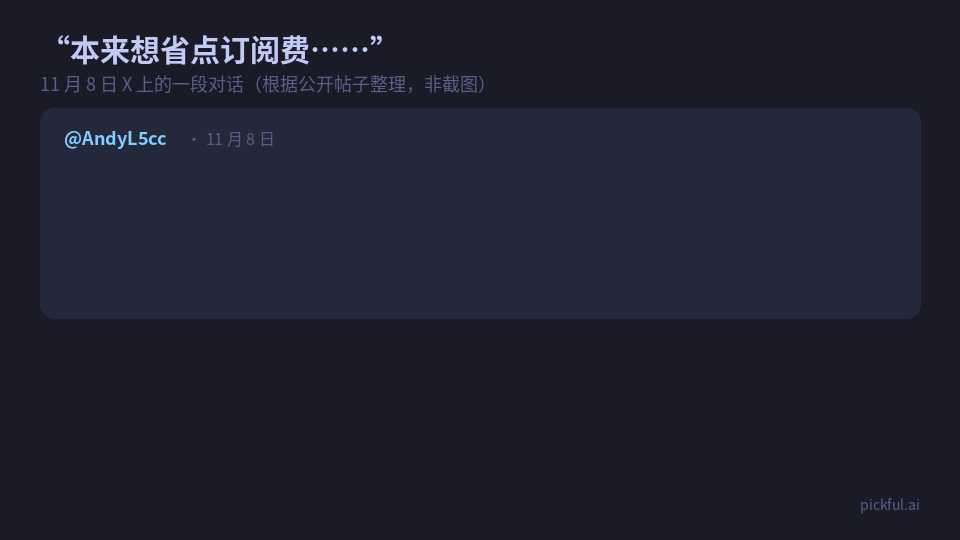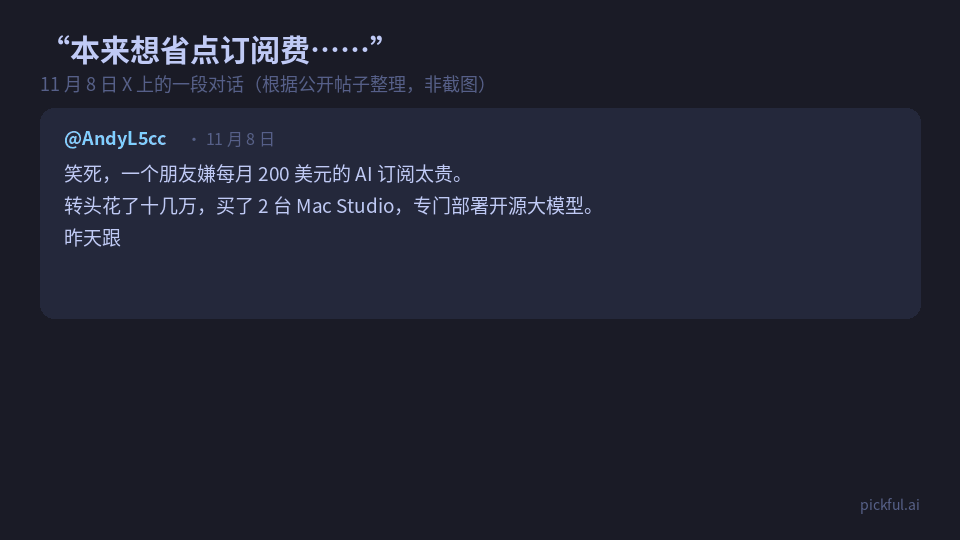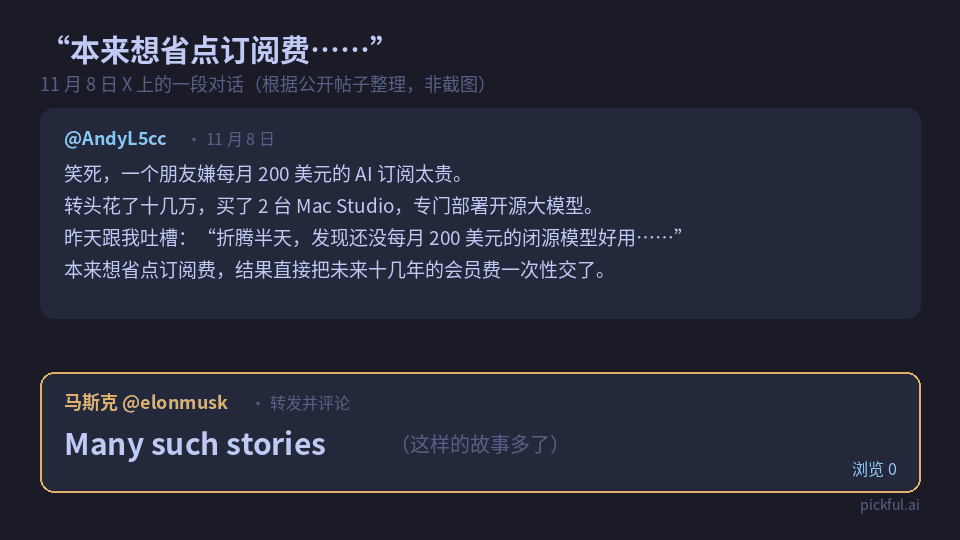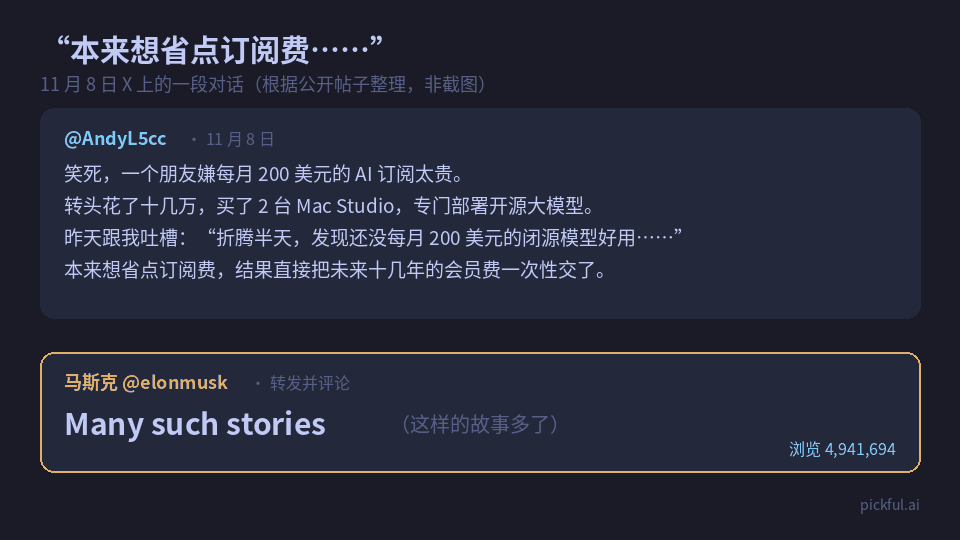
不只我这么算。11 月 8 日,一条中文推文在 X 上传开:有人嫌每月 200 美元的 AI 订阅太贵,转头花了十几万,买了 2 台 Mac Studio 专门部署开源大模型,折腾半天发现“还没每月 200 美元的闭源模型好用”。发帖人的总结是:“本来想省点订阅费,结果直接把未来十几年的会员费一次性交了。”马斯克转发了这条推文,只评了一句:“Many such stories”(这样的故事多了)。这条转发的浏览量接近 500 万。
背后的道理,OpenAI 的 Sam Altman 前不久在播客里讲过:个人电脑里的内存大约只有 5% 的时间在用(这是他自己的估计),而云端通过汇集请求、批量处理,通常更容易把利用率提上去、把成本摊薄。他卖的是云端订阅,这话有立场,但道理成立:云端一次读出的权重可以同时服务一批请求,成本被摊薄;个人机器一次只服务一个人,多数时间还闲着。所以买本地机器之前,先估一估自己真实的使用量:用得越少,越不划算。
本地模型确实有订阅替代不了的地方:
- 隐私:客户资料、内部代码、合规要求,数据不能离开自己的机器;
- 不受平台限制:模型不经过平台的内容策略,回答什么由自己决定;
- 离线、无上限:断网能用,跑批量任务不按额度计算;
- 微调:要训练自己的模型,订阅做不了。
对大多数人,订阅更便宜,模型也更强。上面四条里至少有一条是刚需,买一台 Spark 才说得通。
轉發此貼文?
與您的關注者分享。
回覆